
DeepResearch de bajo coste
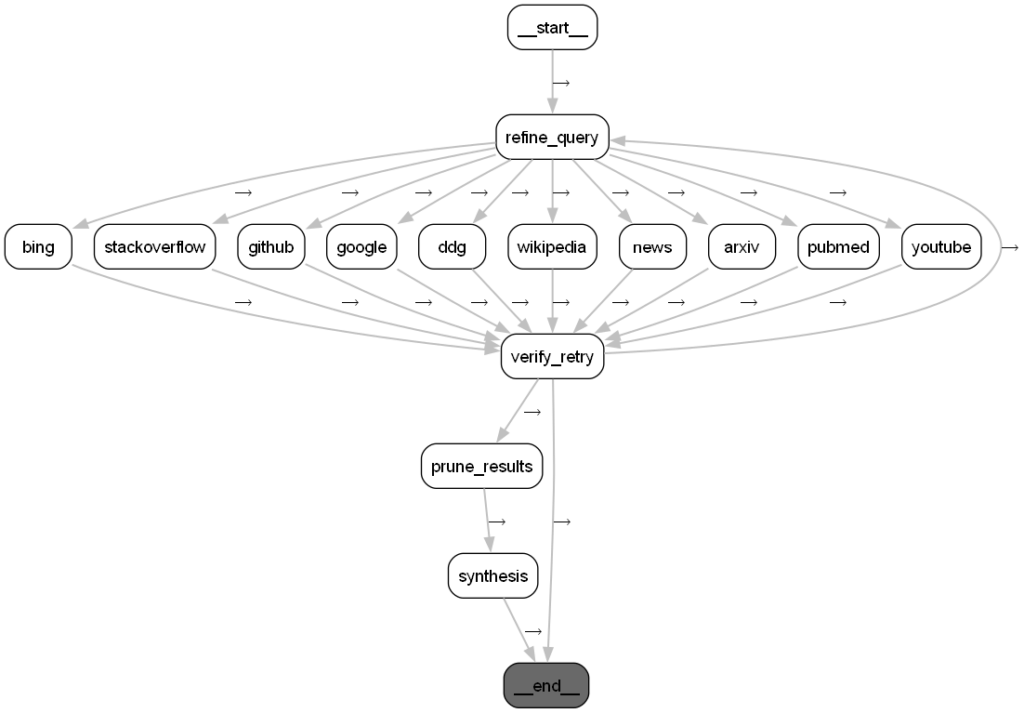
El código implementa un sistema de búsqueda inteligente y verificación de información usando múltiples fuentes online, todo orquestado mediante un grafo de ejecución con LangGraph.
🧠 Propósito general
El sistema toma una consulta del usuario (por ejemplo, “¿Qué son los haplogrupos R1b?”), la refina usando un modelo LLM (DeepSeek), consulta múltiples fuentes (Google, PubMed, Arxiv, Wikipedia, etc.), filtra los resultados irrelevantes, y finalmente sintetiza una respuesta consolidada.
🧩 Componentes principales
1. Configuración inicial
setup_all_tools()carga todas las herramientas disponibles.get_model("Deepseek")inicializa el modelo LLM que refina la consulta y filtra resultados.SYSTEM_PROMPTdefine cómo debe comportarse el LLM para refinar la consulta.PRUNING_PROMPT_TEMPLATEdefine cómo debe comportarse el LLM para filtrar resultados irrelevantes.
2. Estado del agente (AgentState)
Define todos los campos que se van actualizando durante el flujo:
query: consulta original del usuario.refined_query: versión optimizada en inglés.*_result: resultados crudos de cada fuente.*_pruned: resultados filtrados por relevancia.synthesis: resumen final.retry_count: número de intentos.failed_nodes: lista de herramientas que fallaron.node_ready: indica qué nodos se ejecutaron correctamente.
Todos los campos usan
Annotatedpara permitir acumulación o combinación segura en el grafo.
3. Nodos funcionales
🔹 refine_query_node
Usa el modelo DeepSeek para traducir y optimizar la consulta del usuario.
🔹 get_tool_node
Función genérica que ejecuta una herramienta (Google, PubMed, etc.) y guarda el resultado en el estado.
🔹 Nodos específicos
Cada fuente tiene su propio nodo: google_node, pubmed_node, github_node, etc. Todos usan get_tool_node.
🔹 prune_results_node
Filtra los resultados crudos usando el LLM. Elimina errores, irrelevancias y conserva solo los fragmentos útiles.
🔹 verification_retry_node
Verifica qué nodos fallaron y decide si se deben reintentar o continuar con la síntesis.
🔹 synthesis_node
Construye el informe final usando los resultados filtrados. Muestra qué fuentes funcionaron, cuáles fallaron y qué se encontró.
4. Construcción del grafo
Usa StateGraph(AgentState) para definir el flujo:
START → refine_queryrefine_query → [todas las fuentes en paralelo]- Cada fuente →
verify_retry verify_retry → prune_resultsorefine_query(si hay fallos)prune_results → synthesis → END
El flujo es dinámico: si hay errores y no se supera el umbral mínimo de fuentes exitosas, se reintenta hasta
MAX_RETRIES.
5. Ejecución final
python
if __name__ == "__main__":
    question = "what are R1b haplogroups?"
    initial_state = {
        "query": question,
        "retry_count": 0,
        "failed_nodes": [],
        "node_ready": {},
        "synthesis": ""
    }
    answer = research_agent.invoke(initial_state)
    print(answer["synthesis"])
Esto lanza el grafo, ejecuta todos los pasos y muestra el resumen final.
🧪 ¿Qué hace especial este sistema?
- Multifuente: consulta hasta 11 fuentes distintas.
- Robusto: reintenta si hay fallos.
- Filtrado inteligente: usa LLM para limpiar resultados.
- Modular: puedes añadir más nodos fácilmente
- Extensible: ideal para investigación, verificación de hechos o generación de informes.
- Bajo coste
Descarga el codigo de github

The DNA of the Mountains: How the Bronze Age Brought Haplogroup R1b to the Pyrenees – sanchezpares.com
[…] DeepResearch de bajo coste […]