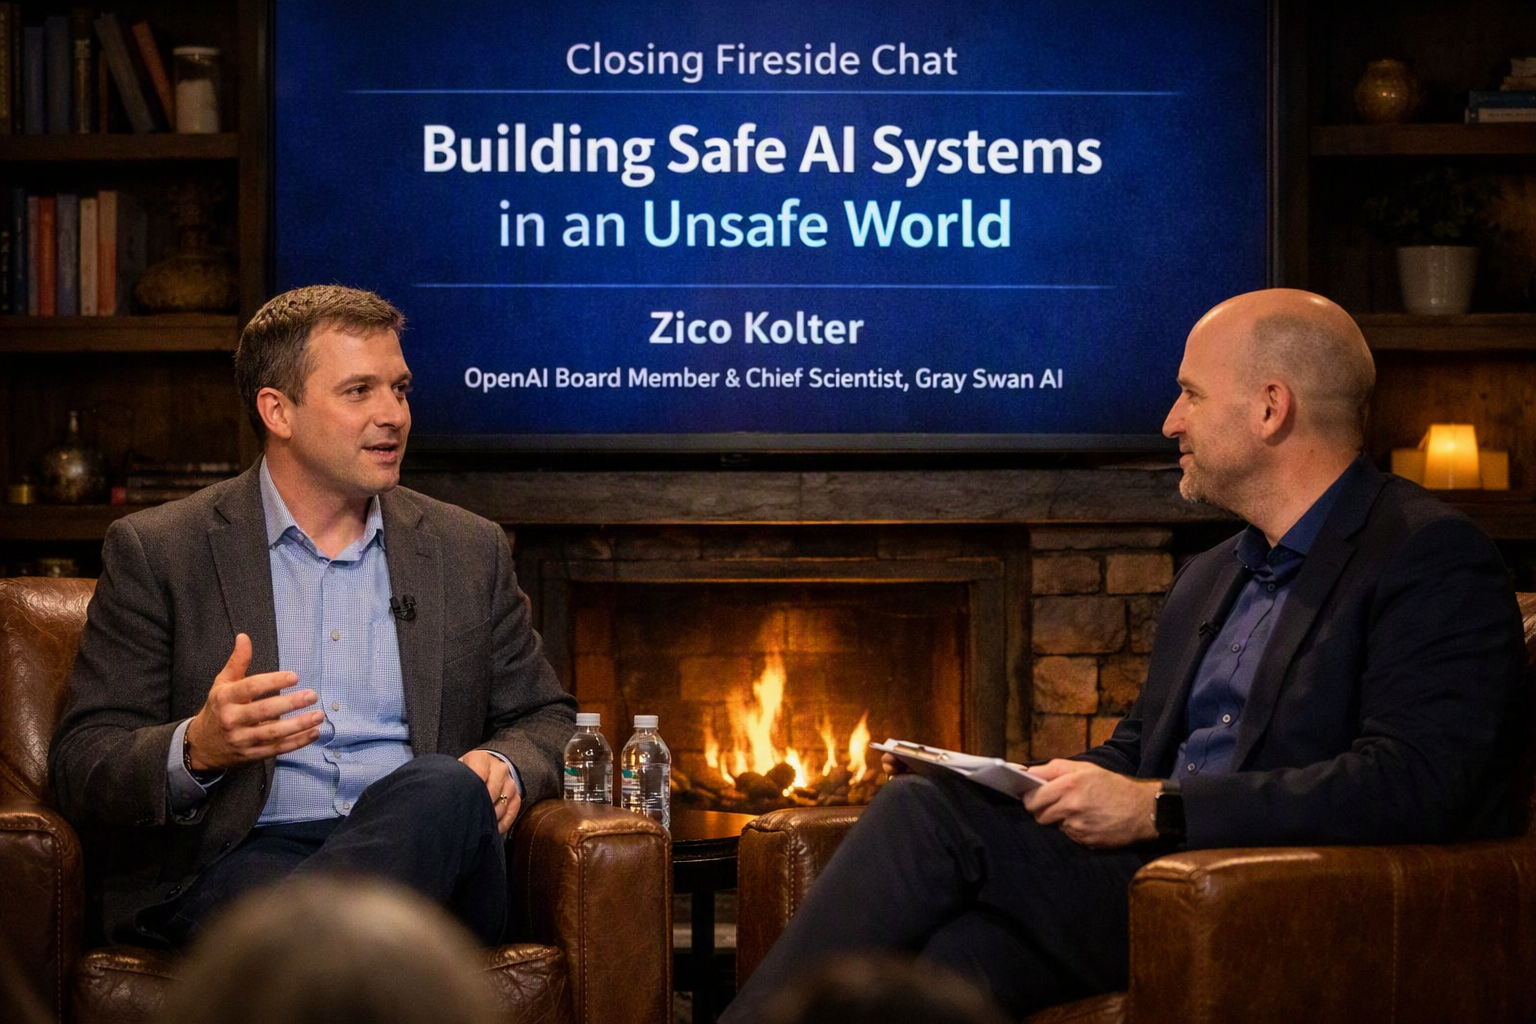
Reseña: Building Safe AI Systems in an Unsafe World — Fireside Chat de clausura con Zico Kolter
Sesión: Closing Fireside Chat — Building Safe AI Systems in an Unsafe World Ponente: Zico Kolter — miembro del Consejo de OpenAI; Chief Scientist de Gray Swan AI; catedrático y director del Machine Learning Department, Carnegie Mellon University. Formato: conversación de clausura sobre seguridad técnica y gobernanza de la IA.
1. Marco: quién habla y desde dónde
La sesión reúne una triple autoridad poco frecuente. Kolter es a la vez investigador académico (coautor del método de certificación de robustez adversarial randomized smoothing, referencia fundacional del campo), cofundador y chief scientist de Gray Swan AI (empresa centrada en seguridad ofensiva/defensiva de IA) y miembro del Consejo de OpenAI, donde preside el comité de Seguridad y Protección que puede detener el lanzamiento de modelos considerados inseguros (AP, 2025; OpenAI, 2024). Esa combinación explica el arco del diálogo: de la matemática del ataque adversarial a la política institucional del despliegue.
2. Eje 1 — Ataques adversariales: una nueva clase de riesgo técnico
Kolter parte de una premisa: los modelos de IA fallan de formas que la ciberseguridad clásica no anticipa. Los vectores incluyen evasión adversarial, envenenamiento de datos (poisoning), extracción e inferencia de información sensible (Ijlal, 2022, p. 75), además de jailbreaks e inyección de prompts en sistemas agénticos. Su contribución más reconocida, Certified Adversarial Robustness via Randomized Smoothing (Cohen, Rosenfeld y Kolter, 2019), demostró que es posible certificar formalmente la robustez de un clasificador ante perturbaciones acotadas, incluso a escala ImageNet. La idea de fondo que traslada a la conversación: sin garantías ni límites verificables, la «confianza» en la IA es solo una intuición.
3. Eje 2 — Herramientas y arquitecturas: red teaming como disciplina propia
Un argumento central de Kolter —repetido en sus intervenciones con Gray Swan— es que la seguridad de la IA no es «ciberseguridad con IA añadida», sino una disciplina con atacantes, tácticas y marcos propios (Latent Space, 2025). En la práctica esto implica:
- Red teaming sistemático contra modelos y agentes, complementario a los equipos blue team y separado de la seguridad tradicional (Ijlal, 2022, p. 73).
- Evaluaciones de riesgo específicas de IA con herramientas como el marco MITRE ATLAS, ART o Counterfit.
- Benchmarks de conducta peligrosa, como el cybersecurity refusal benchmark desarrollado por Gray Swan para medir la capacidad de los modelos de rechazar tareas ilegales o dañinas.
- Arquitecturas que incorporen monitoreo y observabilidad continua desde el diseño (bucles de retroalimentación, pruebas en entornos limitados y escenarios reales) en lugar de tratar la seguridad como un parche posterior al despliegue (Gangavarapu, 2025, p. 40).
4. Eje 3 — Fallas de gobernanza: el eslabón más débil
El título del chat anticipa su tesis sociotécnica: los modelos no se vuelven seguros automáticamente por ser más potentes; de hecho, Kolter ha señalado que mayor capacidad puede agravar ciertos riesgos si no hay controles proporcionales. La gobernanza deja de ser un trámite y se convierte en el verdadero cuello de botella: quién decide qué riesgo es aceptable, con qué evidencia y con qué autoridad para frenar. Su posición institucional en OpenAI —donde el comité de seguridad puede bloquear lanzamientos— convierte esa discusión abstracta en un experimento en vivo sobre checks and balances dentro de un laboratorio de frontera.
5. Eje 4 — Operar en un mundo inseguro: observabilidad y confianza
La parte final del diálogo aborda la inserción de la IA en empresas y sociedad: modelos embebidos en decisiones de negocio exigen seguridad, observabilidad y fiabilidad como requisitos operativos, no como valores añadidos. Esto implica estandarización de riesgos (NIST AI RMF, OWASP LLM Top 10), monitoreo de deriva (drift), registro de eventos y mecanismos de rollback, así como la colaboración academia-industria-gobierno que Kolter impulsa desde programas como el AI Safety Science de Schmidt Sciences (CMU, 2025).
6. Valoración crítica
Fortalezas: el diálogo conecta con credibilidad los tres niveles —matemático (certificación), técnico (red teaming) e institucional (gobernanza)— y evita tanto el alarmismo como el tecno-optimismo ingenuo. Su insistencia en que la seguridad debe ser medible y auditable es una contribución valiosa frente a los discursos puramente declarativos sobre «alineación».
Tensiones: quedan preguntas abiertas que el propio formato de fireside chat tiende a suavizar: la compatibilidad entre los incentivos comerciales de un laboratorio de frontera y la autoridad real de su comité de seguridad; el posible conflicto de interés de un investigador que es a la vez regulador (Consejo de OpenAI) y proveedor de soluciones de seguridad (Gray Swan); y si las certificaciones actuales, limitadas a perturbaciones pequeñas y dominios concretos, escalan a agentes autónomos de alto impacto.
7. Conclusión
Building Safe AI Systems in an Unsafe World funciona como cierre conceptual de un programa: sintetiza la agenda de seguridad de Kolter —ataques adversariales como riesgo técnico, red teaming y evaluación como herramientas, gobernanza con poder de veto como marco operativo— y la proyecta hacia el reto societario: construir sistemas que sean no solo potentes, sino seguros, observables y dignos de confianza en un mundo que no los espera con garantías.
Fuentes principales
- AP News (2025). Who is Zico Kolter? A professor leads OpenAI safety panel with power to halt unsafe AI releases.
- OpenAI (2024). Zico Kolter joins OpenAI’s Board of Directors / Safety & Security Committee.
- Cohen, J., Rosenfeld, E. y Kolter, Z. (2019). Certified Adversarial Robustness via Randomized Smoothing (arXiv:1902.02918). / ICLR 2025 — Building Safe and Robust AI Systems (invited talk).